2026年9月18日
开发测试平台研发端 AI Agent 落地实践
介绍云蝶AI产研平台研发端 AI Agent 的落地实践,包括研发流程、Agent Skills、技术方案生成、质量门禁和实践问题处理。
一、项目整体说明
大家好,上一个版本实现了开发测试平台的产品端AI Agent的基本功能和流程,同时也跑通了AI Agent Skills和平台业务数据的对接,目前看效果还不错,为了更快的用AI来迭代这个平台,同时也为了实现需求端到测试端的闭环,开发完成了研发端的AI Agent功能,也打通了产品端的需求内容。
为了让这个产品有更高的品位,所以先改了一个名字,目前叫云蝶AI产研平台。取意为云的变化无常,蝴蝶每次飞舞带来的微小的能量波动都有可能导致更深远的影响,所以希望这个产品每进步一次都可以有能力承接这些变化,另外一方面就是希望在这个平台上构建产品可以通过AI更好的管理软件开发过程中的一系列问题,比如流程问题,组织问题,效率问题,协作问题,尽可能的借助AI+平台的能力来推动软件开发生产关系的变革。
为了让新读者来了解下项目情况和做的内容,可以先阅读下前面的公众号文章:
下面详细介绍下V1.2.0版本的技术实现。
1.1 研发流程说明
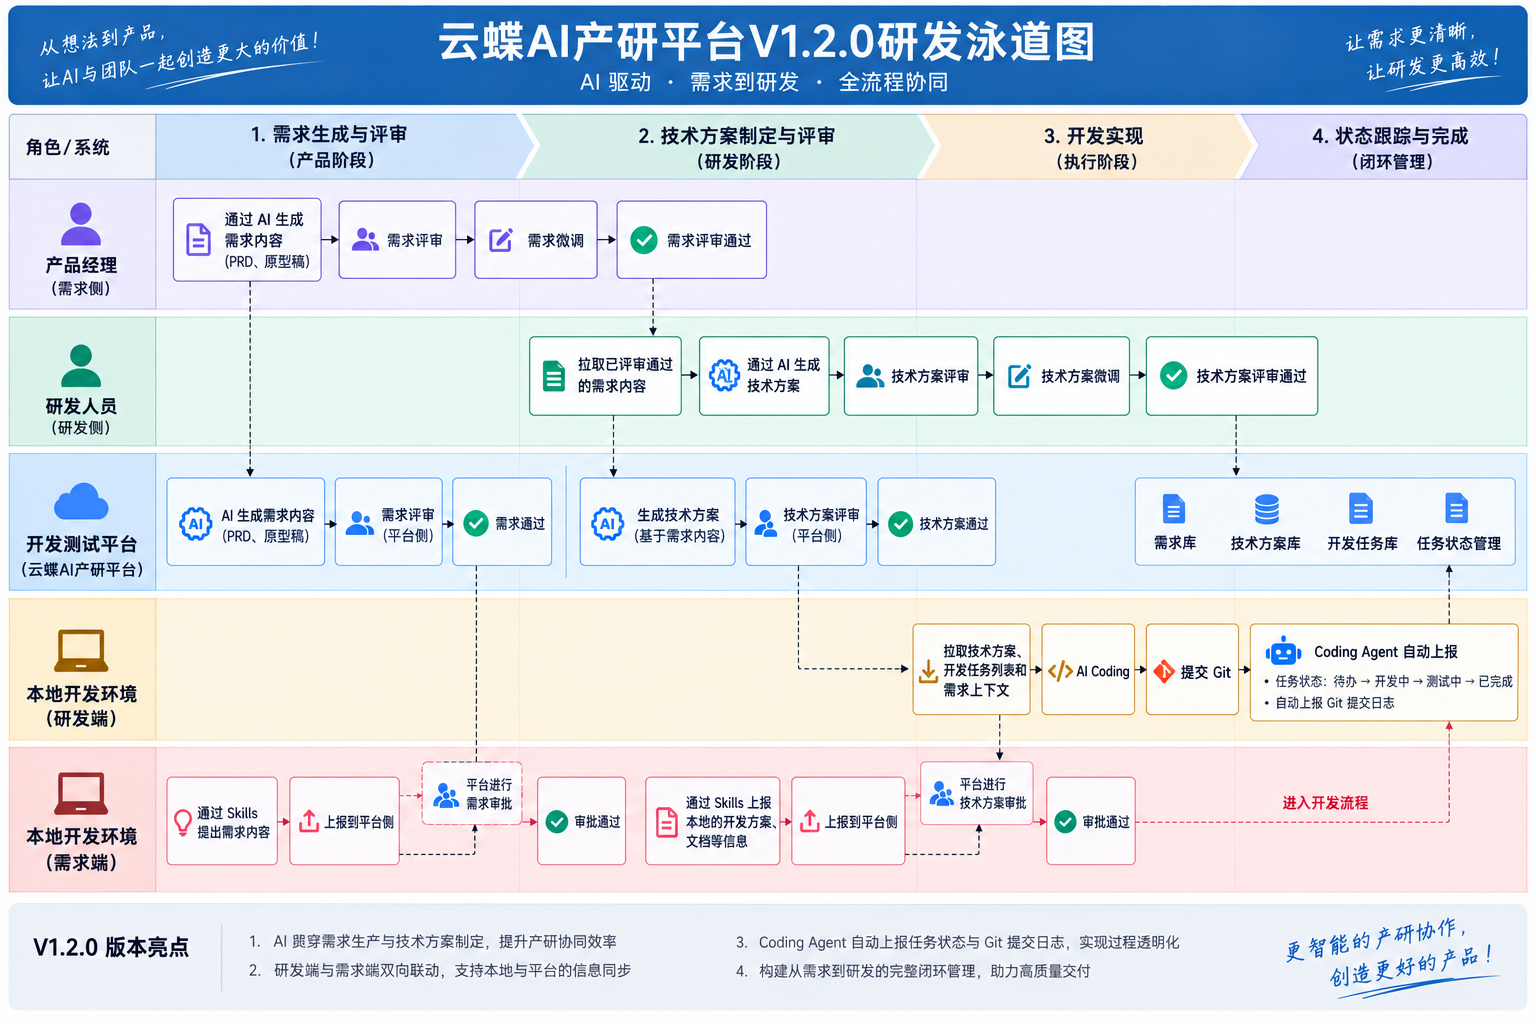
详细看下下面的 研发流程图可以看到,这个版本已经实现了平台驱动 + 本地执行的产研开发模式。
1.2 研发端本地使用的AgentSkills
| Skills名称 | Skills描述 | 说明 |
|---|---|---|
| fetch-dev-context | 拉取平台侧的技术方案和开发任务相关等上下文 | 本次版本新增 |
| report-dev-process | 把本地开发任务的状态与进度说明回写到开发测试平台 | 本次版本新增 |
| report-commit | 把本地分支、commit SHA、commit message 与代码变更摘要回写到开发测试平台 | 本次版本新增 |
| report-review-result | 把代码 Review 结果(PR 地址、评审人、评审状态、评审意见)回写到开发测试平台 | 本次版本新增 |
| report-self-test | 把本地自测执行结果(命令、结论、失败原因、报告地址)回写到开发测试平台的开发过程记录 | 本次版本新增 |
| develop-tech-proposal | 按平台需求 ID 拉取研发上下文,在当前代码仓库编制技术方案,并在用户确认后回传平台 | 本次版本新增,这里实际上是两个动作,是连贯的 |
| submit-requirement-draft | 在本地开发环境提交需求草稿到开发测试平台 | 本次版本新增 |
| import-interface-doc | 导入 Swagger 或 OpenAPI JSON 接口文档到开发测试平台 | 从java侧挪到python侧维护 |
| publish-interface-artifact | 发布接口时序图或调用依赖 JSON 到开发测试平台 | 从java侧挪到python侧维护 |
Skills特色如下:
- 支持一键脚本安装,一键脚本升级
- 支持市面上90%以上的主流AI Coding Agent
- 没有直接用通用的或者比较火爆的Skills,而是借鉴了他们的特点结合当前项目场景了做了优化
1.3 研发端Agent Skills说明
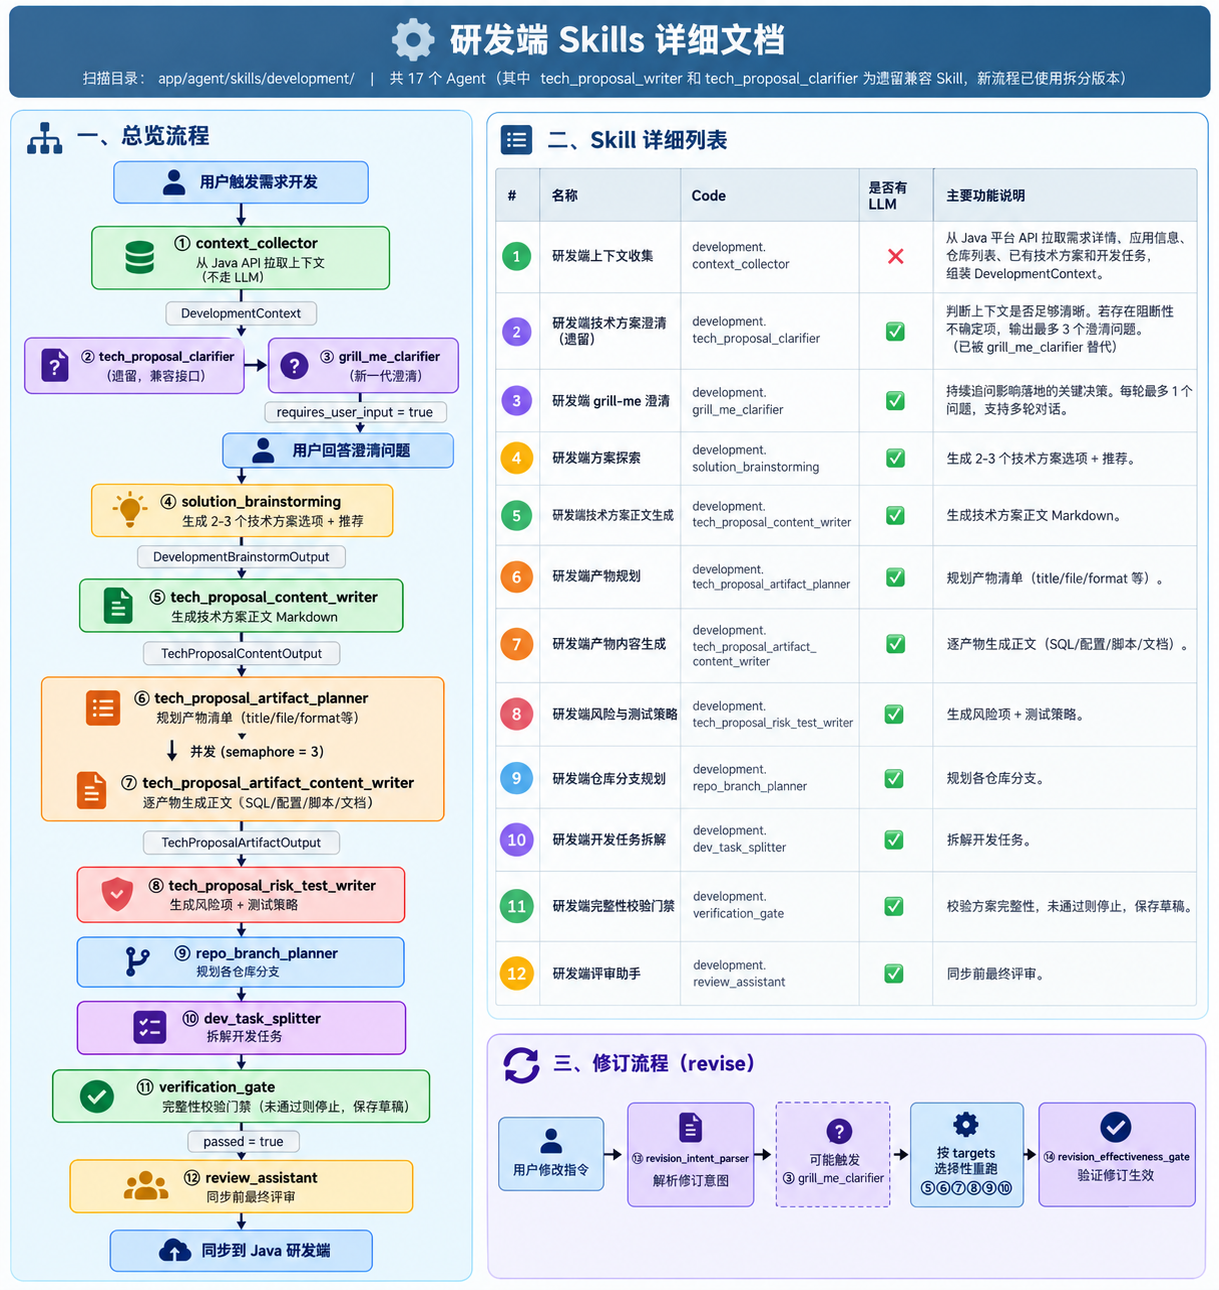
研发端的agent skills在python侧,可以逐步升级,或者单个升级,同时对AI生成的内容进行校验,有质量门禁,提前暴露一些问题。
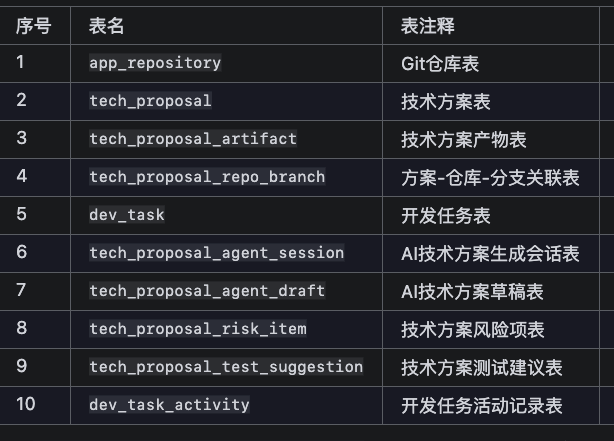
1.4 新增表描述
1.5 核心代码说明
技术方案生成的整个业务流程跟产品需求生成差不多,只是多了很多产物,都是带有审批和AI微调的,这里仅仅介绍python侧的核心代码,java侧主要通过open接口来承接流程和数据。
dev-test-plat-py/app/agent/skills/development: 存放研发端agent skills,1.3有说到
"""Reliable runner for AI tech proposal sessions.

负责驱动技术方案生成和修订的 Worker 层服务。

流程概览:
  1. generate(): 为新需求生成技术方案(含多轮澄清 → 方案探索 → 正文/产物/风险 → 分支/任务 → 校验)
  2. revise():   为已有方案的修订生成新版本草稿
  3. _generate_revision_from_existing(): 在 generate 流程中发现已有正式方案时走修订路径

所有中间结果通过 Repository 持久化,进度/澄清/失败通过 Java HTTP 回调通知前端。
"""
tech_proposal_session_service.py


"""研发端 Agent 工作流编排器。

负责编排 17 个 Skill 的完整执行链路,支持两条主流程:

  generate 流程(run):
    上下文压缩 → brainstorming → 方案正文 → 产物规划+生成 → 风险/测试
    → 分支规划 → 任务拆解 → 完整性校验 → 同步前评审

  revise 流程(revise):
    意图解析 → (可选澄清) → 按目标选择性重跑 content/artifacts/risk_test/branch/task
    → 修订生效校验

每个 Skill 调用统一走 run_with_quality_retry(格式断言 + 维度覆盖 + 错误回灌重试),
产物生成采用两阶段策略(planner 规划 → content_writer 并发写正文)以避免超长输出截断。
"""
development_workflow.py


"""研发端 Agent 应用服务。

该服务负责把一次“基于需求生成研发方案”的完整业务链路串起来:

1. 创建 Python 侧 Agent 执行记录;
2. 从 Java 侧拉取需求、应用、仓库、既有技术方案、既有开发任务;
3. 调用研发端 Skills 生成技术方案、仓库分支规划、开发任务拆分和 Review 结果;
4. 记录每个 Skill Step 的输入、输出、质量指标、Token 与成本;
5. 在 Review 通过且调用方允许同步时,把结果回写到 Java 侧;
6. 更新执行记录为成功或失败。
注意:当前方案定位是“平台侧研发数据管理 + 本地 Coding Agent 上下文供给”,
这里不会直接修改业务代码、创建 Git 分支、提交 Commit 或发起 MR/PR。
"""
development_service.py


"""Persistence for AI tech proposal agent sessions.

Java 侧的 ``tech_proposal_agent_session.id`` 是唯一的会话标识(canonical id)。
Python 不另分配内存 id,而是直接复用 Java 提供的 id,确保:
  - API 重启后 session 状态不丢失
  - Python 进程间不会因本地计数器碰撞而产生冲突

所有持久化操作均通过 MySQL ``agent_tech_proposal_session`` 表完成,
采用 PyMySQL 异步 cursor,不依赖任何 ORM。
"""
tech_proposal_repository.py


"""后端 API 契约与客户端文档一致性校验。

以后端 api-doc.md 为权威源,校验前端/移动端接口文档中的接口路径、
HTTP 方法、鉴权方式、请求/响应字段和错误码是否一致。

校验逻辑:
  - _parse_contract():解析 api-doc.md 中的端点、鉴权、字段、错误码
  - validate_client_api_contract():以上下文为权威比对客户端文档差异
  - _compare_scalar():标量字段(鉴权等)精确比对
  - _compare_subset():集合/字典字段(字段列表、错误码等)子集比对
    后端有而客户端缺少的记为缺失,客户端多出的单独记录(不过滤)
"""
api_contract_consistency.py


"""产物一致性校验:以 SQL DDL 为基准,对比 ER 图和接口文档的字段与类型。

SQL DDL 是模式定义的唯一权威来源。所有产物生成完毕后,对 ER 图和接口文档
进行一致性校验,输出的差异信息可用于引导 Skill 自动修复。

校验逻辑:
  - parse_sql_schema():从 SQL DDL 提取表结构(表名 → 字段名 → 类型)
  - parse_er_schema():从 Mermaid erDiagram 块提取 ER 图定义
  - parse_api_fields():从 Markdown 参数表格提取接口字段及类型
  - _compare_er() / _compare_api():以 SQL 为权威源比对差异

类型规范化:SQL 方言别名(int4/integer/timestamp with time zone 等)统一映射
到基准类型,API 侧别名(int32/long/datetime 等)同样归一化后比较。
"""
artifact_consistency.py
1.6 遇到的问题
- 上下文撑爆的问题
技术方案生成的时候由于涉及到很多产物,所以没法一下子都生成出来,所以如果需求内容过大或者过多,大模型那边很容易超过设置的max Token Limit。所以在研发端的Agent 中让大模型分为以下内容开始分批逐步生成
- 技术方案文档
- 推荐分支,
- SQL,Nacos配置,E-R图
- 开发任务列表
- 风险和测试建议
经过以上分割设计之后生成技术方案的稳定性和正确性都得到了很大的提升。
- API中转站拉黑的问题
之前在群里用了大佬分享的API大模型中转站,感觉效果很不错,用了一段时间,然后在进行开发AI商品中心链路功能的时候薅的太厉害被拉入黑名单了~~~~~~
-
大模型幻觉
在研发端Agent实践落地的过程中出现了两个幻觉
-
技术方案微调的时候很容易就重新整体生成,然后出现上下文撑爆的问题
-
生成出的产物不一致(技术方案里的API 文档和Sql,E-R图的内容字段不一致)
解决:
第一个问题的解决就是前端提供选择框让用户主动告知要改哪些方面的内容,是否需要重新全量生成,然后在prompt里增加了一些规则约束,防止技术方案文档里出现了说有SQL内容,但是方案产物里没有SQL文件,同时也要求SQL内容之类的不要在方案文档里出现,进一步降低上下文撑爆的风险
第二个问题就是在AI生成之后通过一些检测脚本,来检测生成的产物是否和文档一致,如果不一致,还要再加一轮AI对话来重新修正,类似于增加了一个Hook机制或者Harness的约束。
以上问题的另外一个本质的问题就是意图识别,就是你说的一些技术术语或者一些词语大模型无法揣测或者准确判断出你到底要微调技术方案的哪些内容哪些地方,所以在python工程里加了一个意图识别层,类似于做查询改写来让AI判断出真正要改的地方。
- grill-me Skills引发的问题
研发端Agent在开发之初就将superpowers和grill-me中比较好的skills拿过来用了,但是在实践中还是有一些问题,就是由于没有讲对话内容进行存储,导致每次生成技术方案过程中都会问一些重复的问题
解决:java侧新增表结构记住grill-me相关的内容,同时限制提问次数
但是这里还有一个问题就是如果提问问题太多会导致啰嗦,针对一些事实或者暂时无法回答的情况或者前后矛盾的情况,可能会让开发者感到厌烦。后续这里还有优化空间。
- 生成的方案产物不够稳定
在生成接口文档的时候,方案文档里仅仅只有接口声明,没有更详细的出参和入参数,技术方案评审内容缺失
解决:api接口文档内容单独生成一个markdown文件,另外使用prompt和质量门禁skills来保障生成的接口文档足够规范和完善。
二、AI研发流程实践
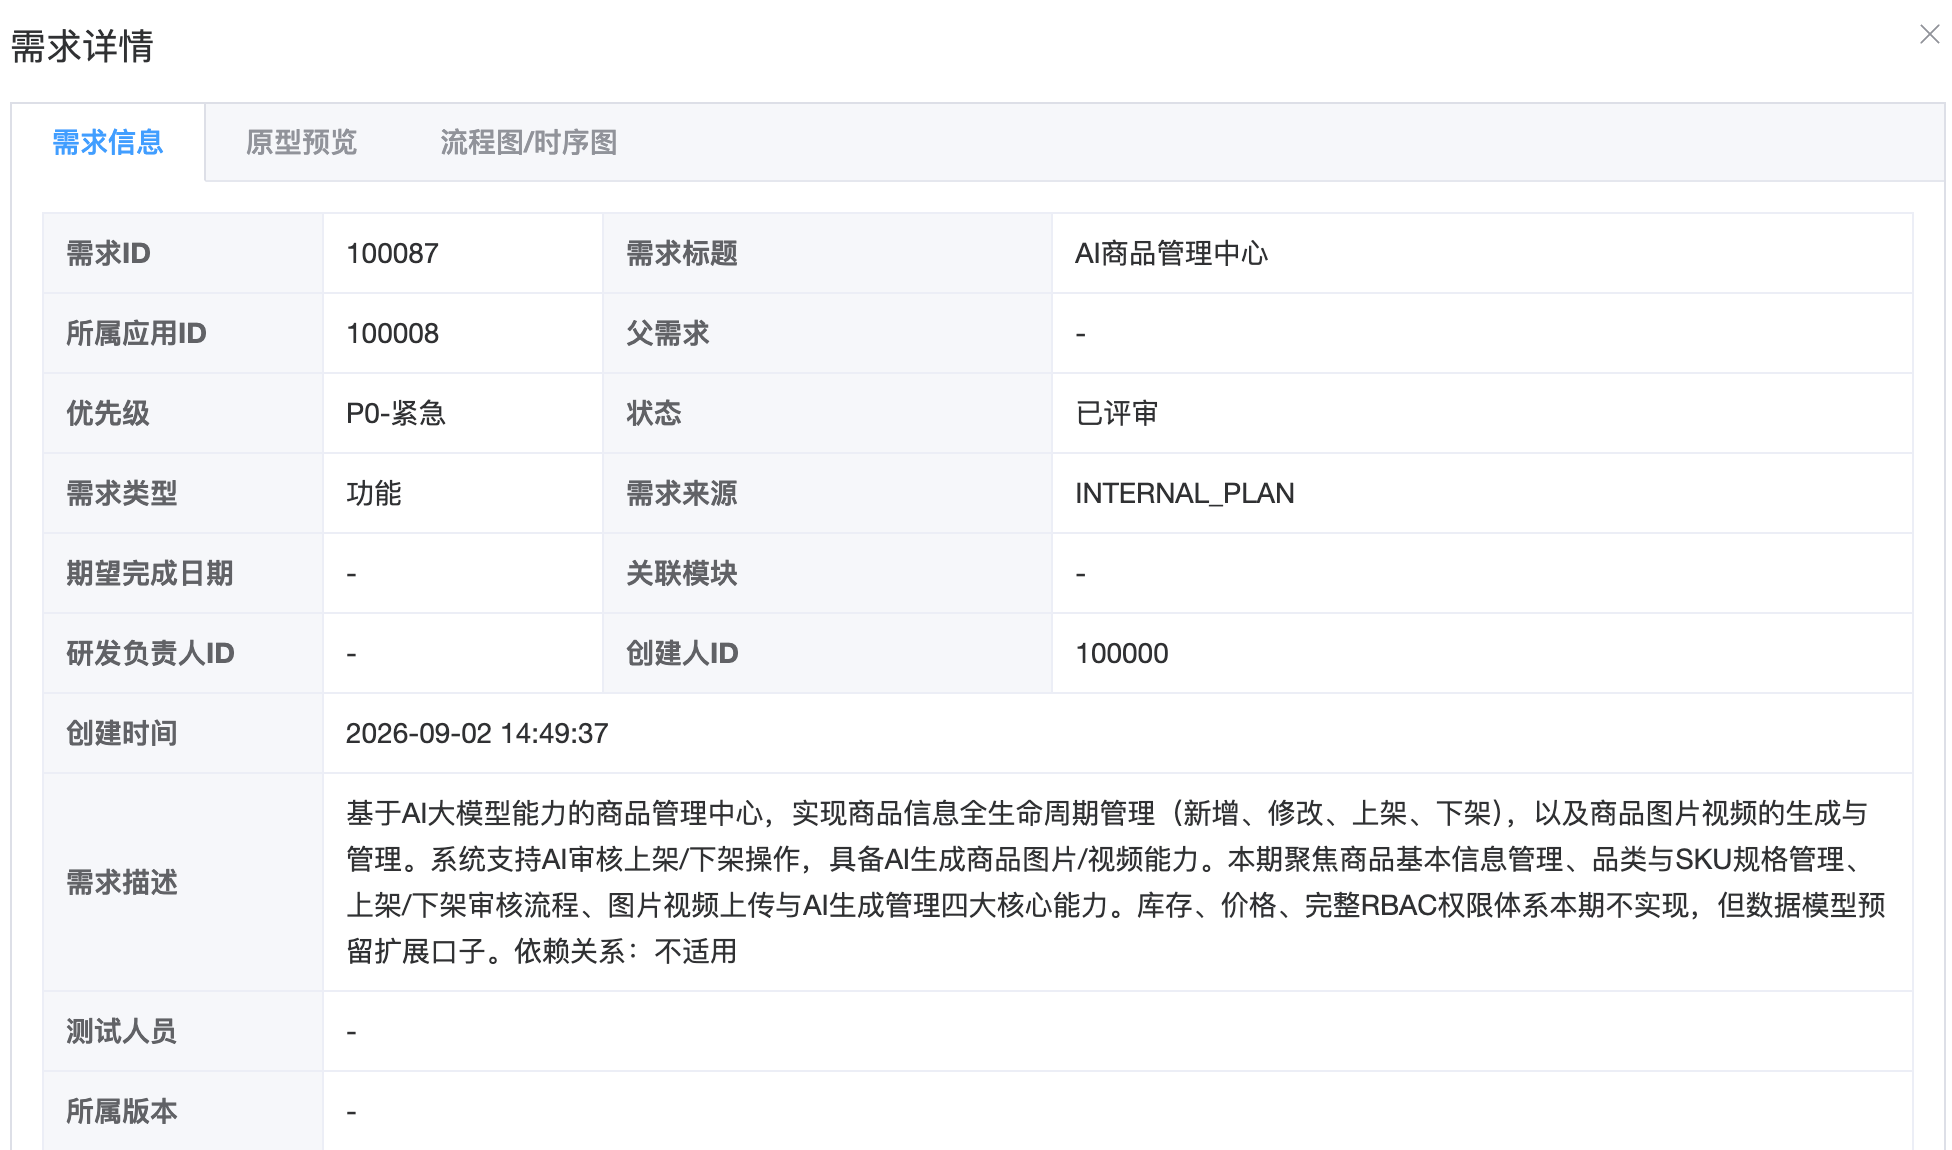
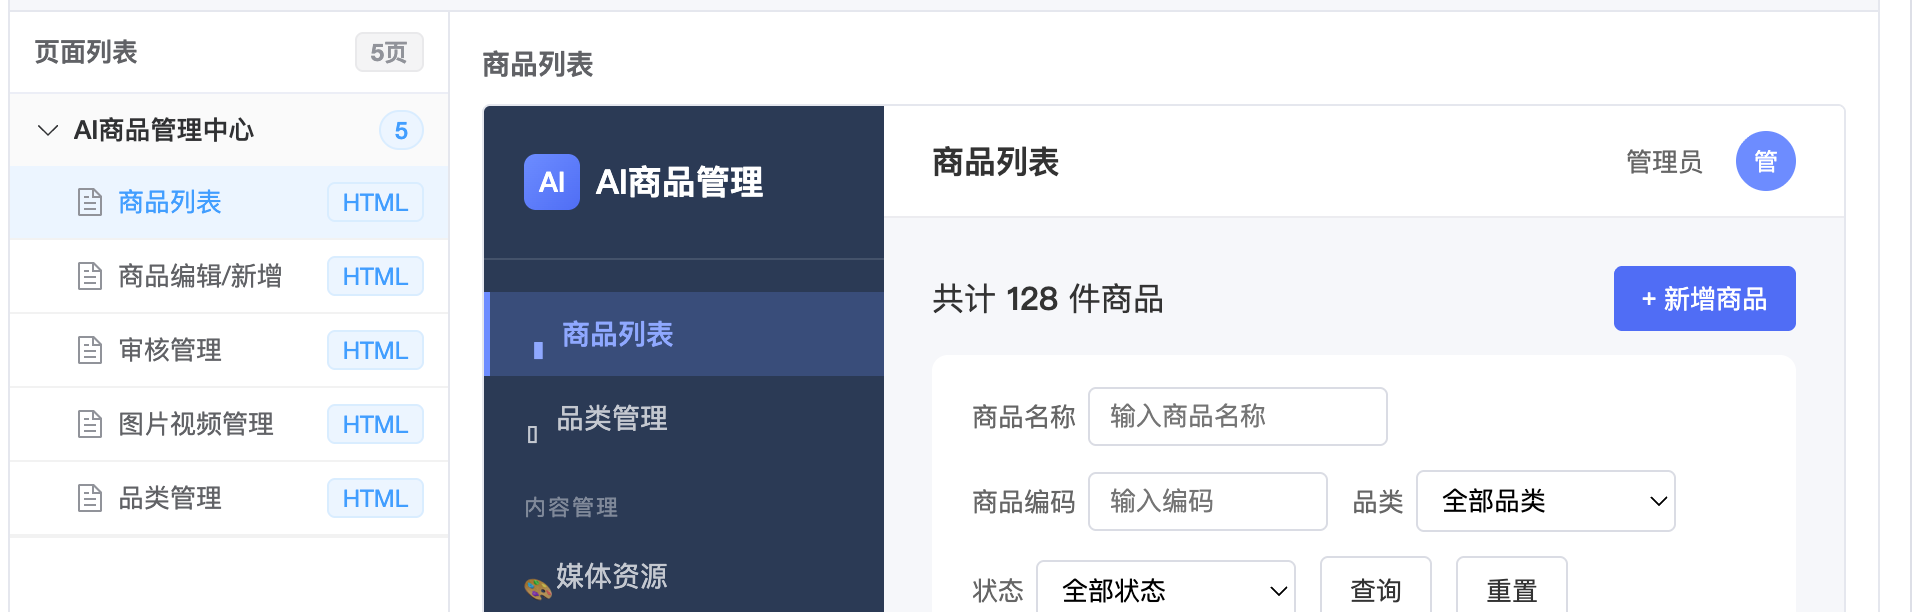
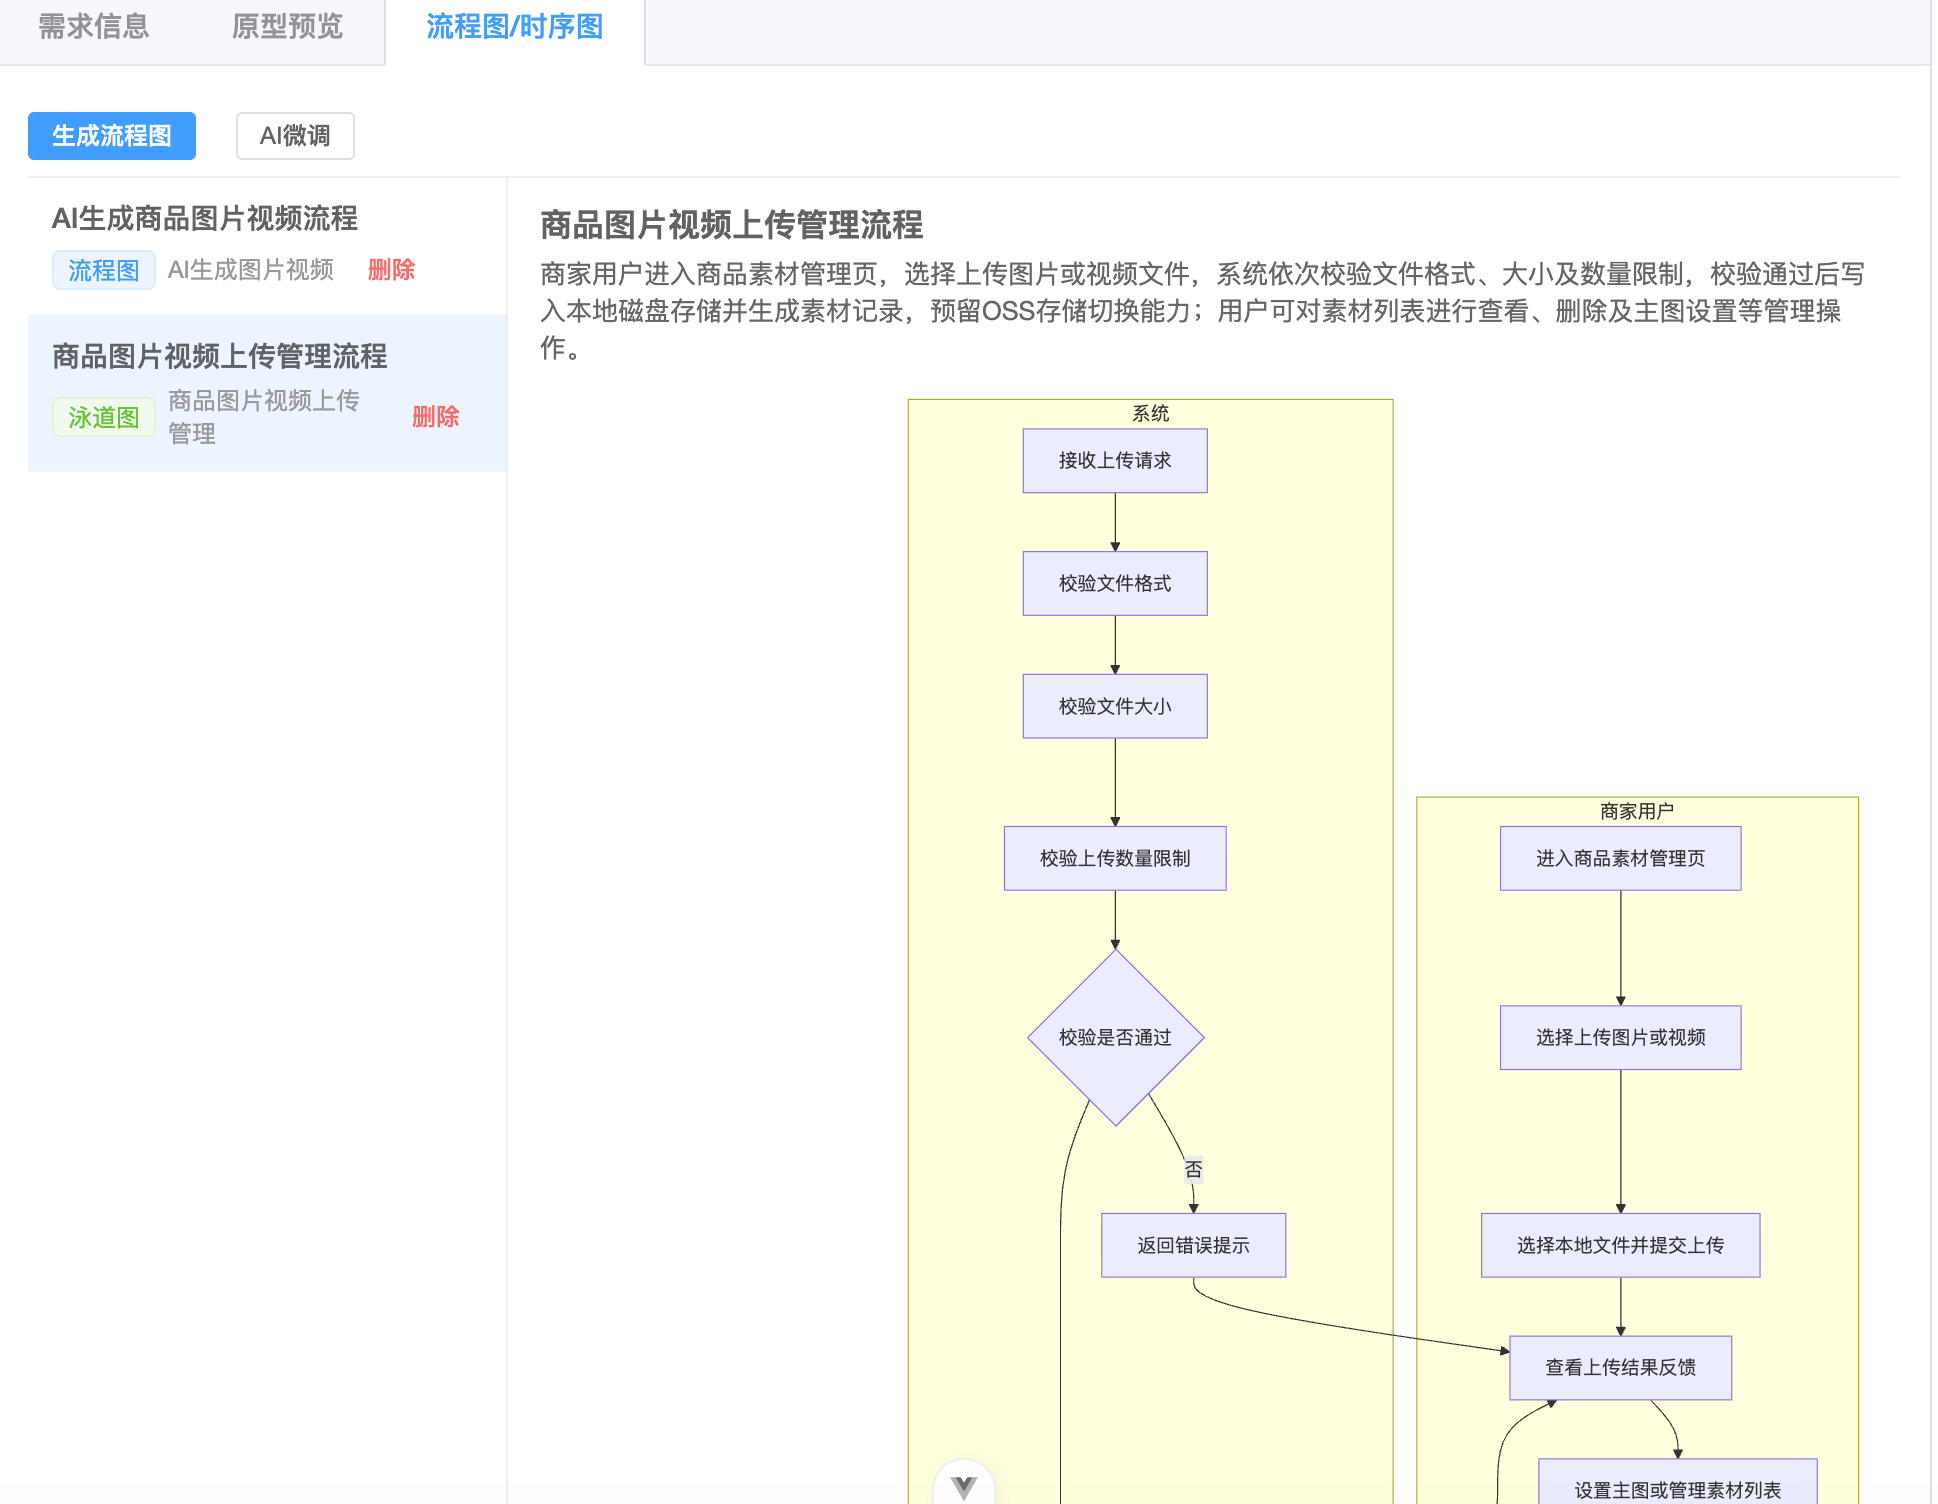
为了完整的跑通整个业务流程,这里我用AI新建了一个需求:AI商品管理中心,需求内容如下图
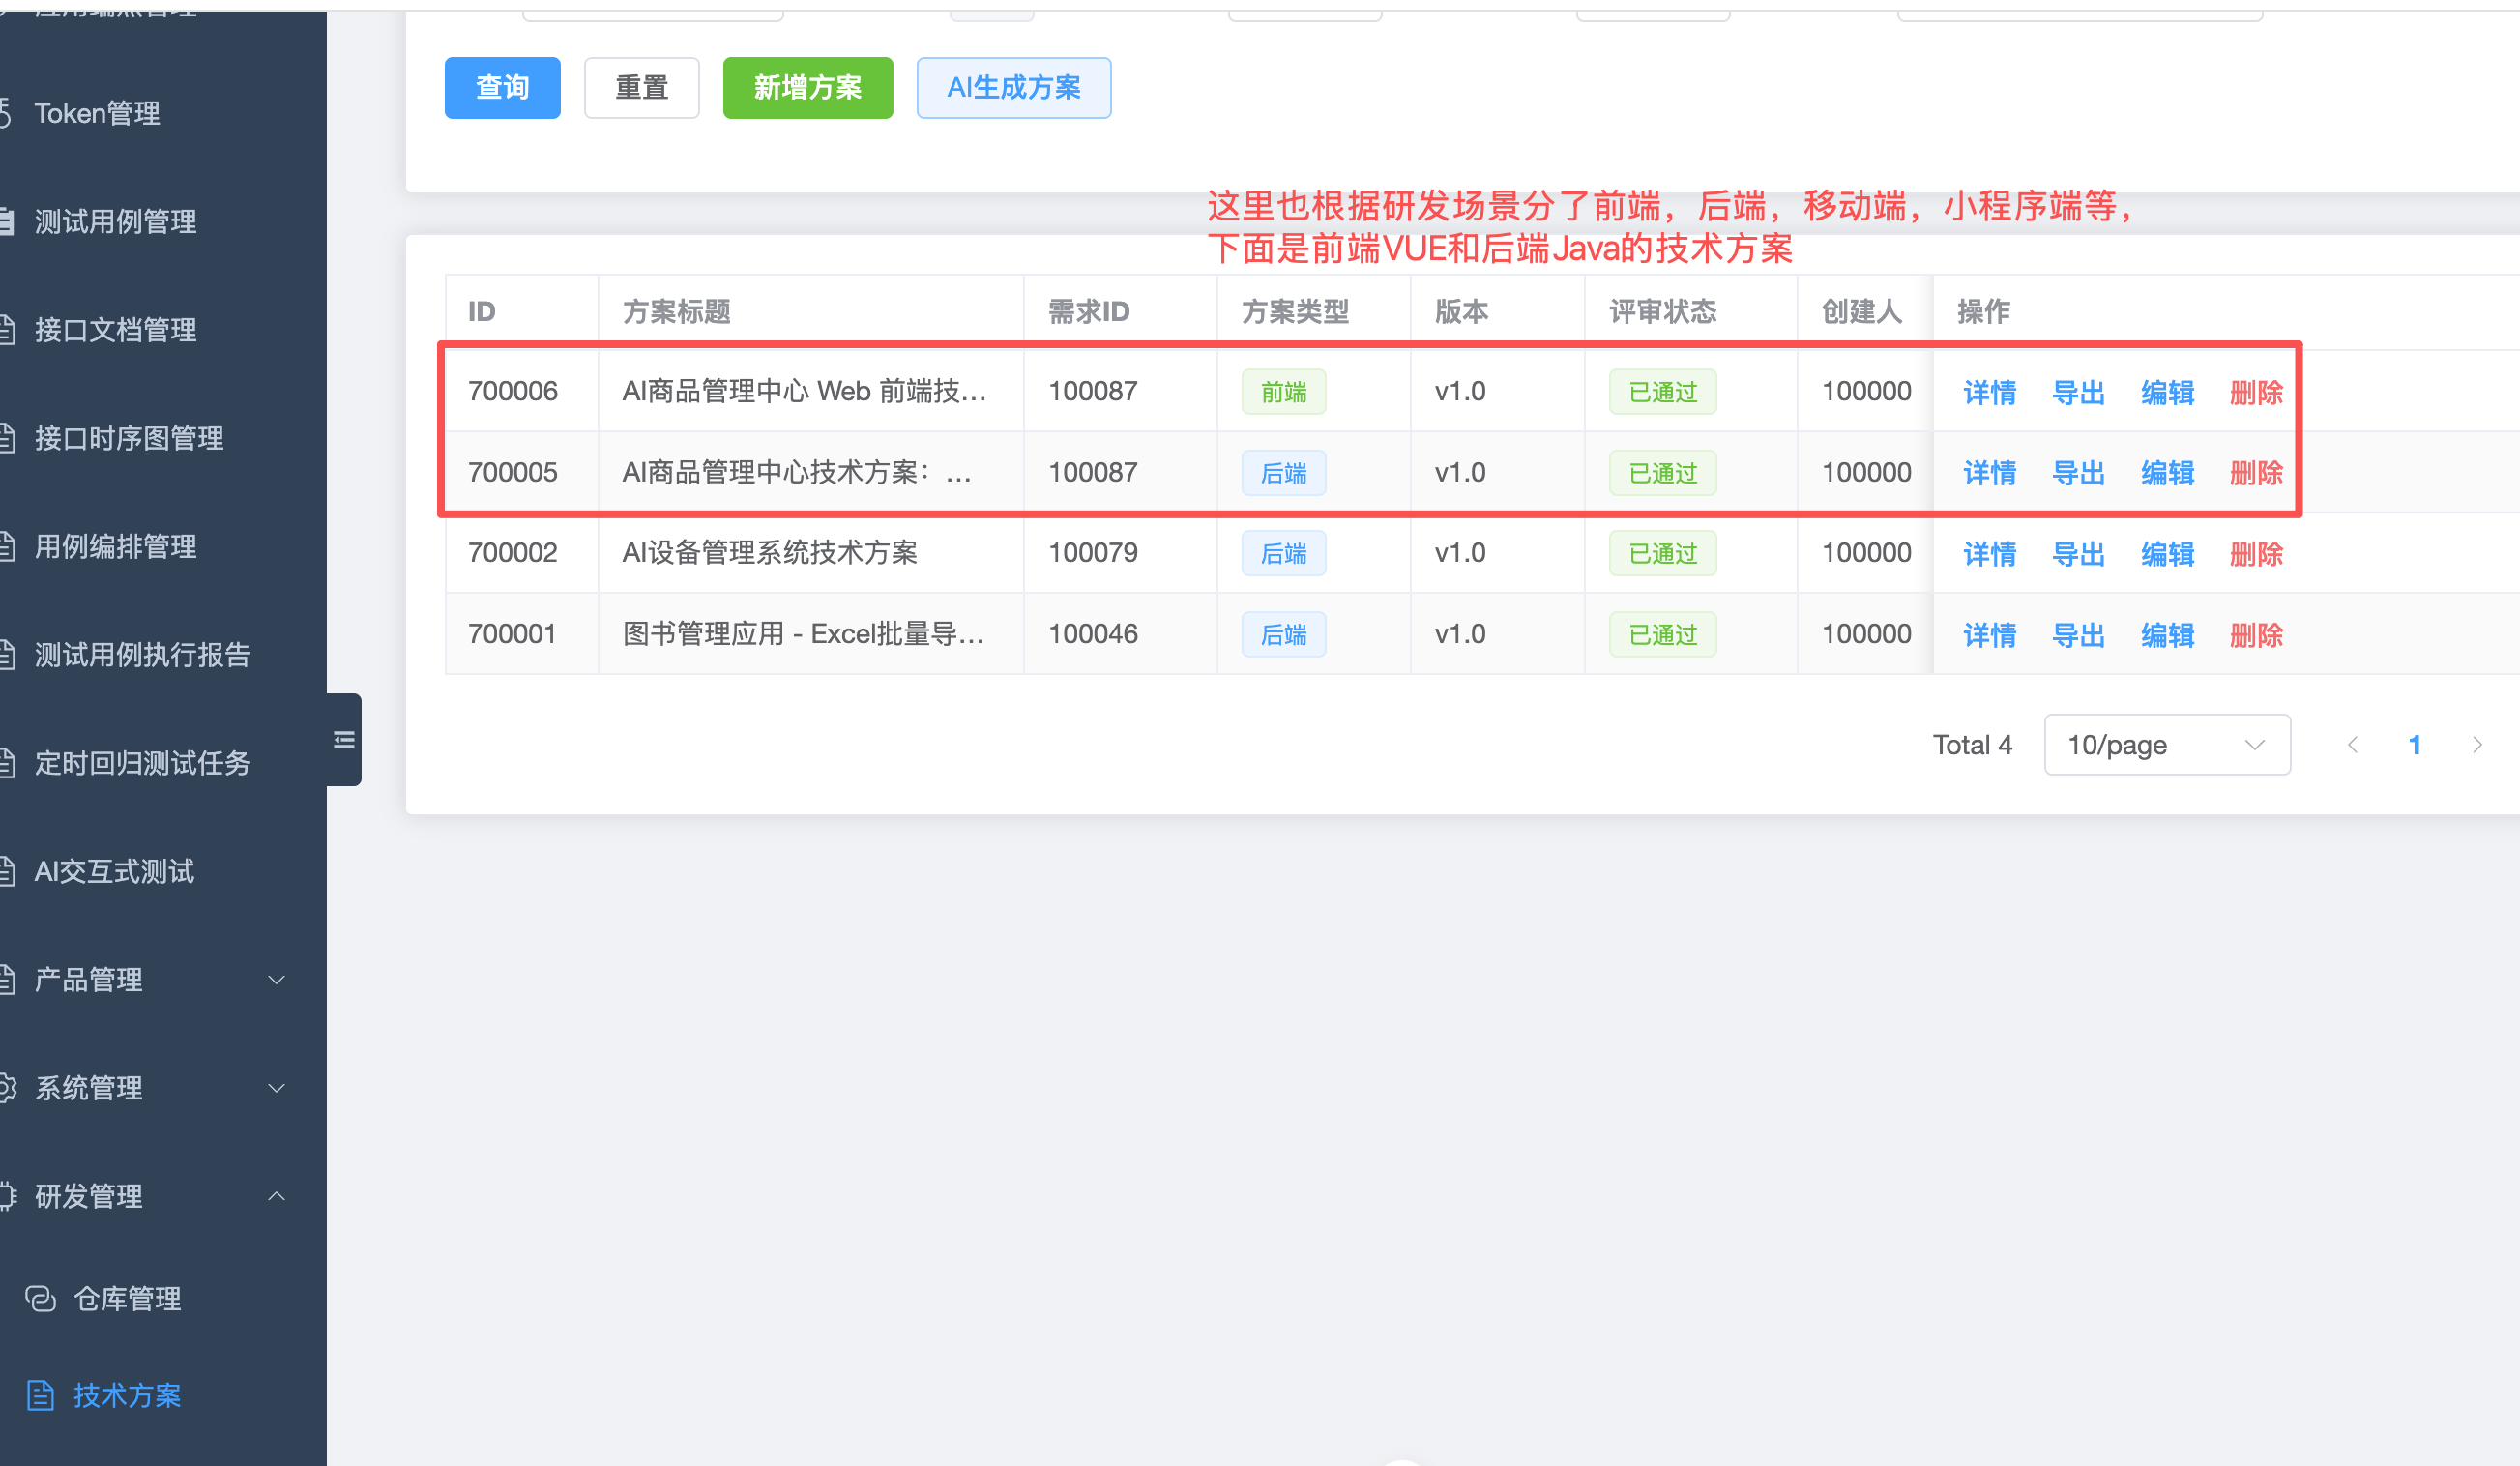
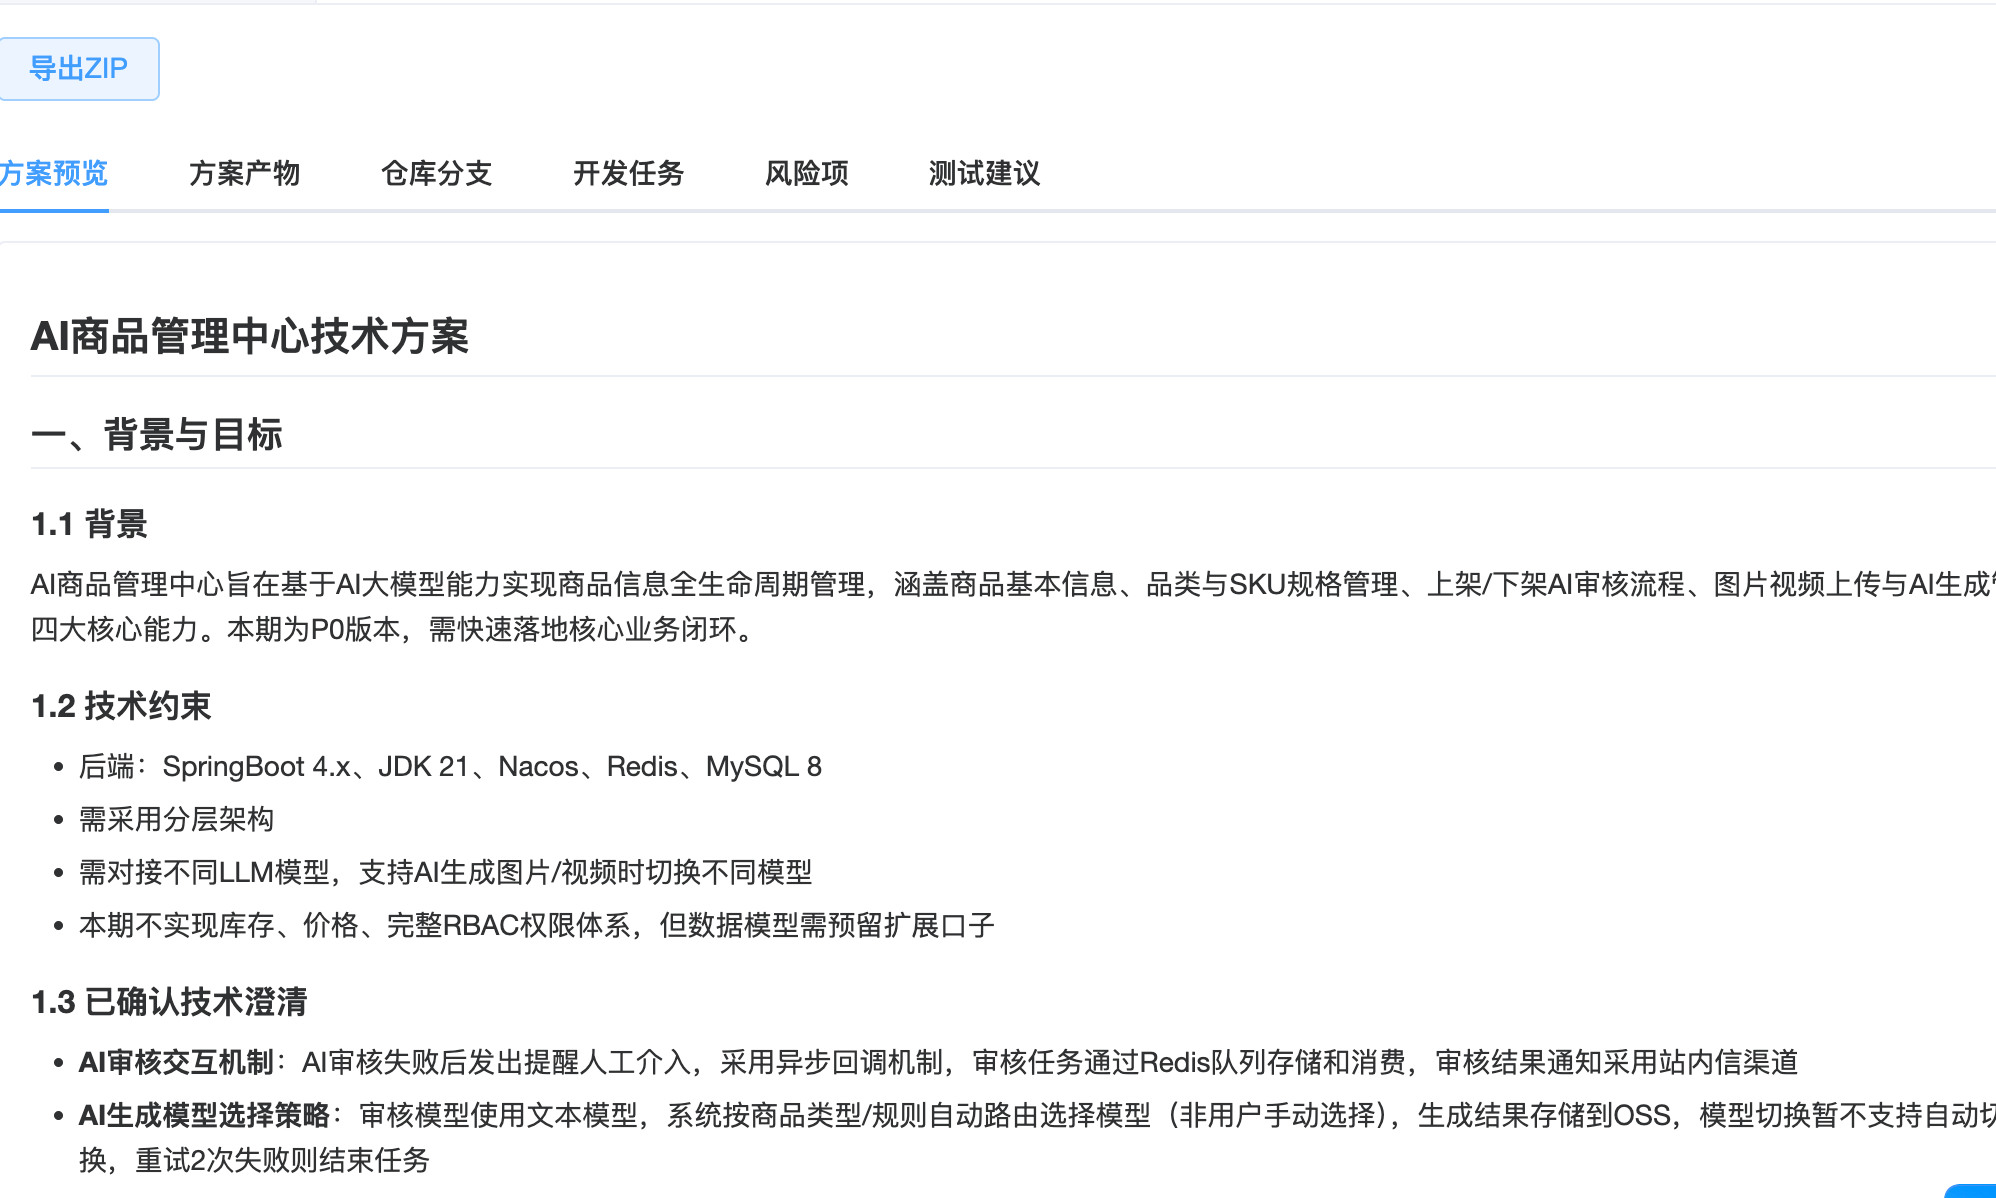
研发端的技术方案和相关产物如下:
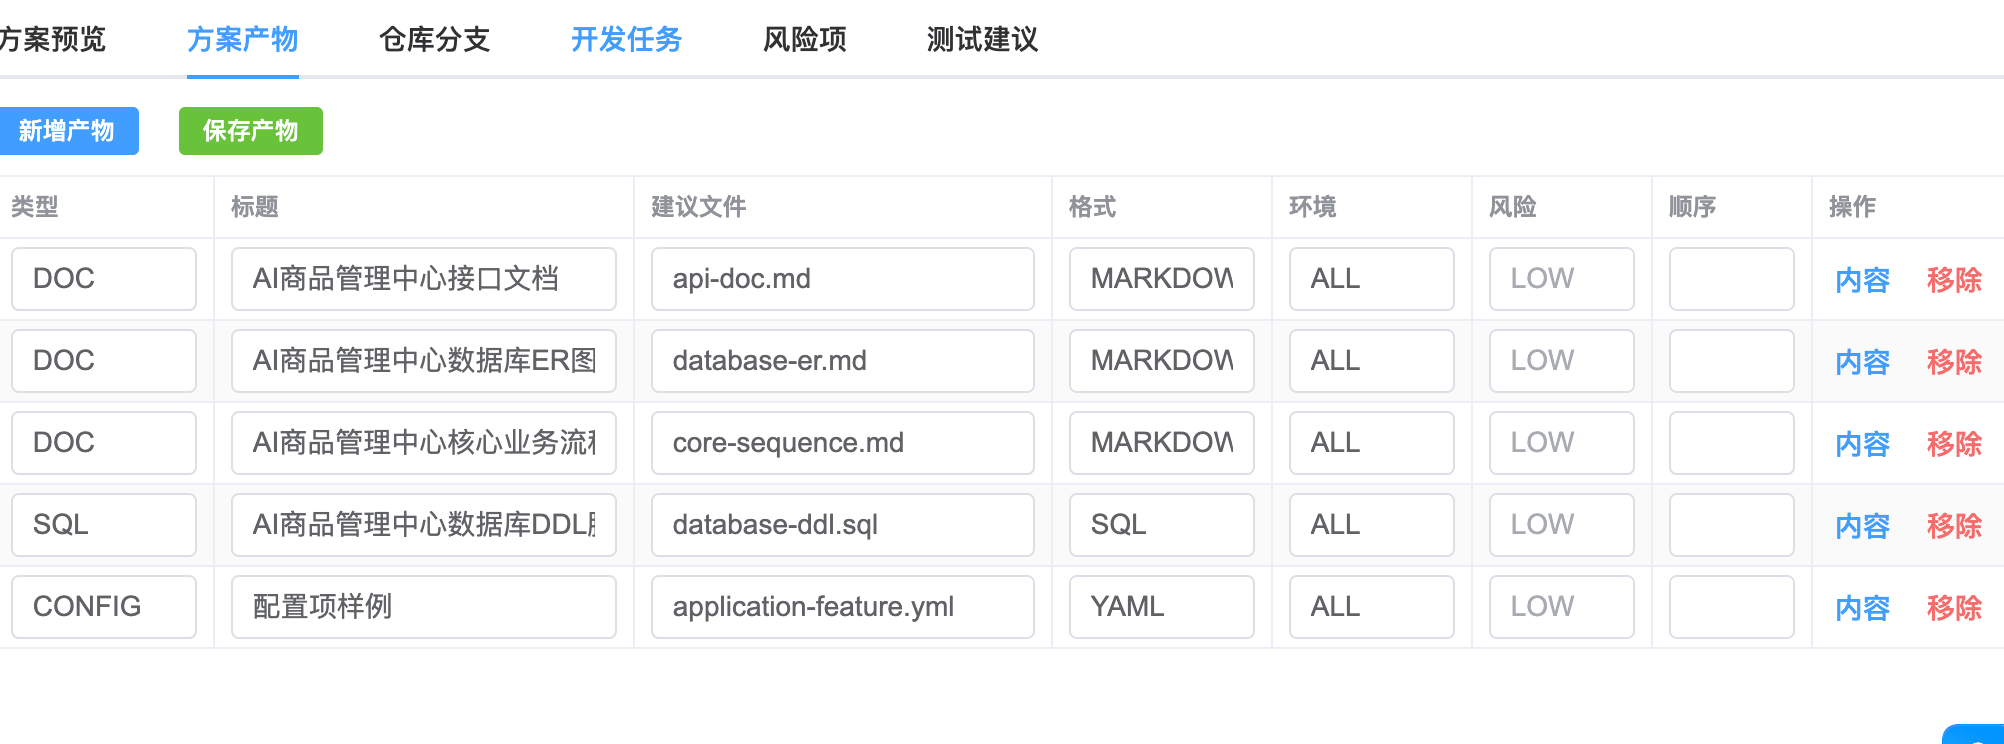
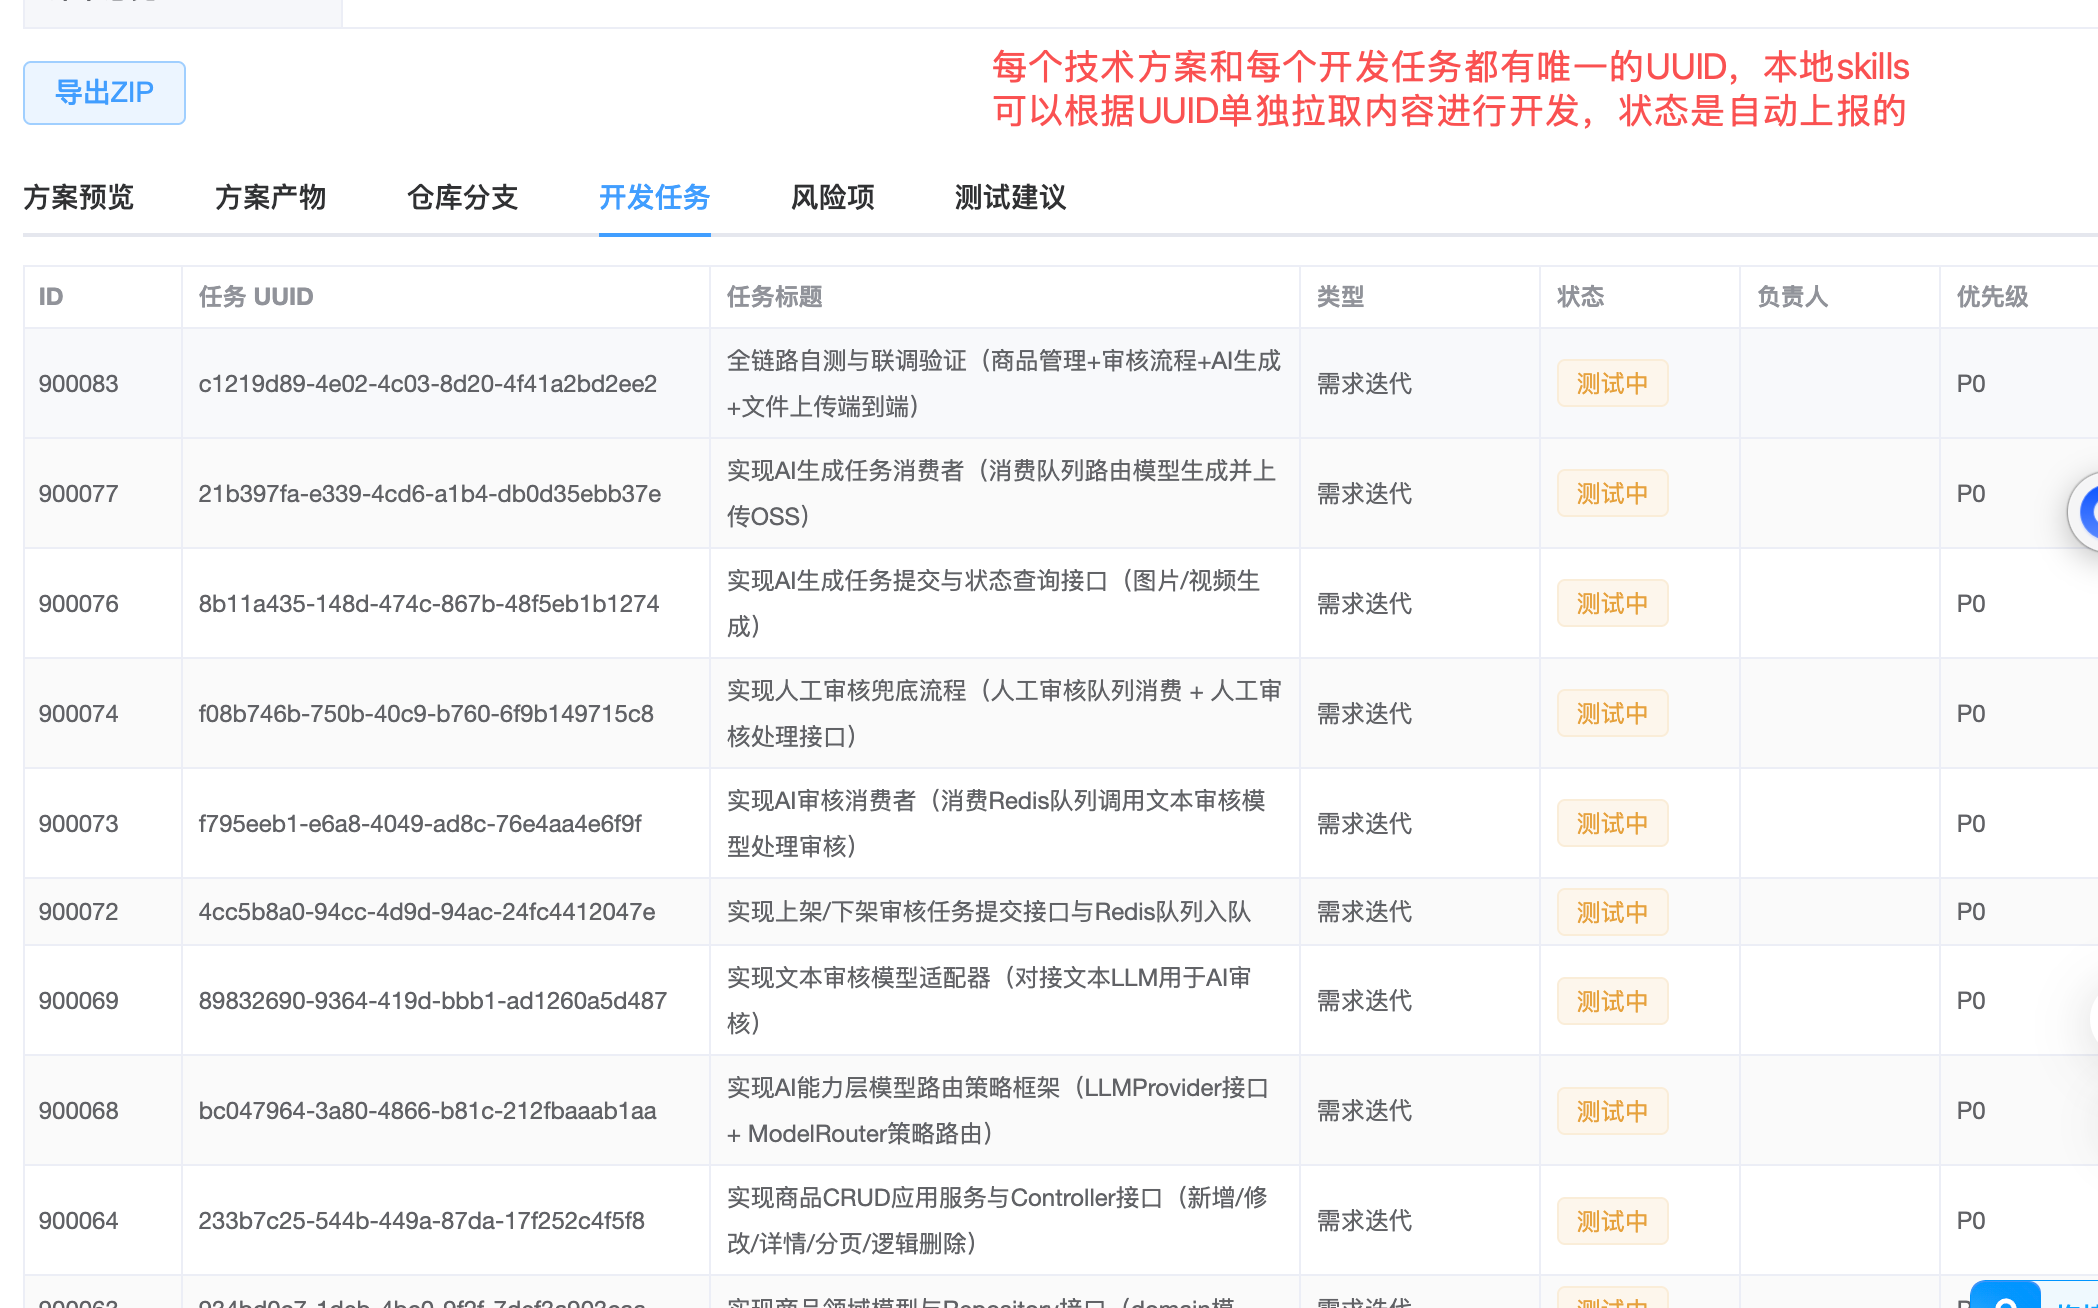
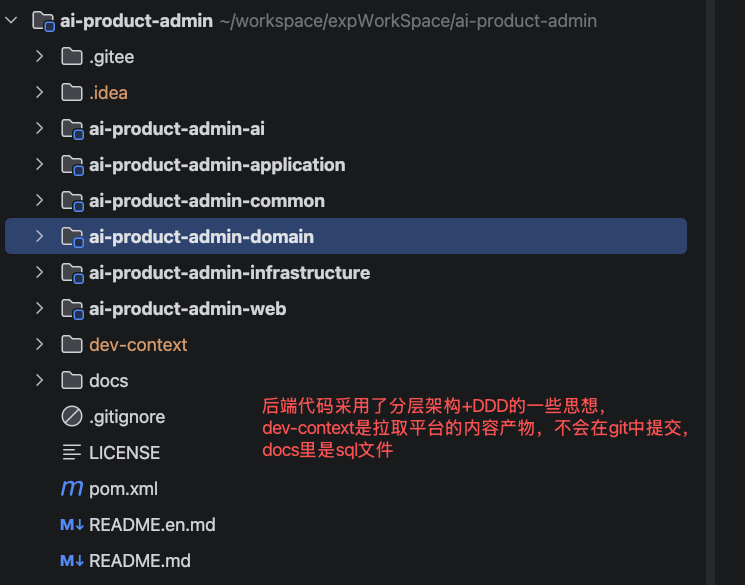
商品中心前后端git地址:
前端地址:
https://gitee.com/codergit.com/ai-product-admin-web
后端地址
https://gitee.com/codergit.com/ai-product-admin
其他说明:
- 前端基于codex+superpowers6的版本进行开发
- 后端基于claude opus5开发
- 整个开发过程中没有手动写一行代码,另外耗时3天,主要在任务自测环节和大模型读取上下文内容的耗时过多,另外也涉及到一些上下文信息的压缩整理等,相当于是一个长任务开发过程,在实践过程中还有如下小问题:
- 后端端到端测试有些代码不需要,比较慢
- 一次性根据任务列表和优先级进行开发交付维度过大,且比较消耗token,经常触发上下文压缩
- 前端根据superpower6.0的方式用子agent和worktree的方式目前看还有点小问题不够丝滑
三、产品演示页面
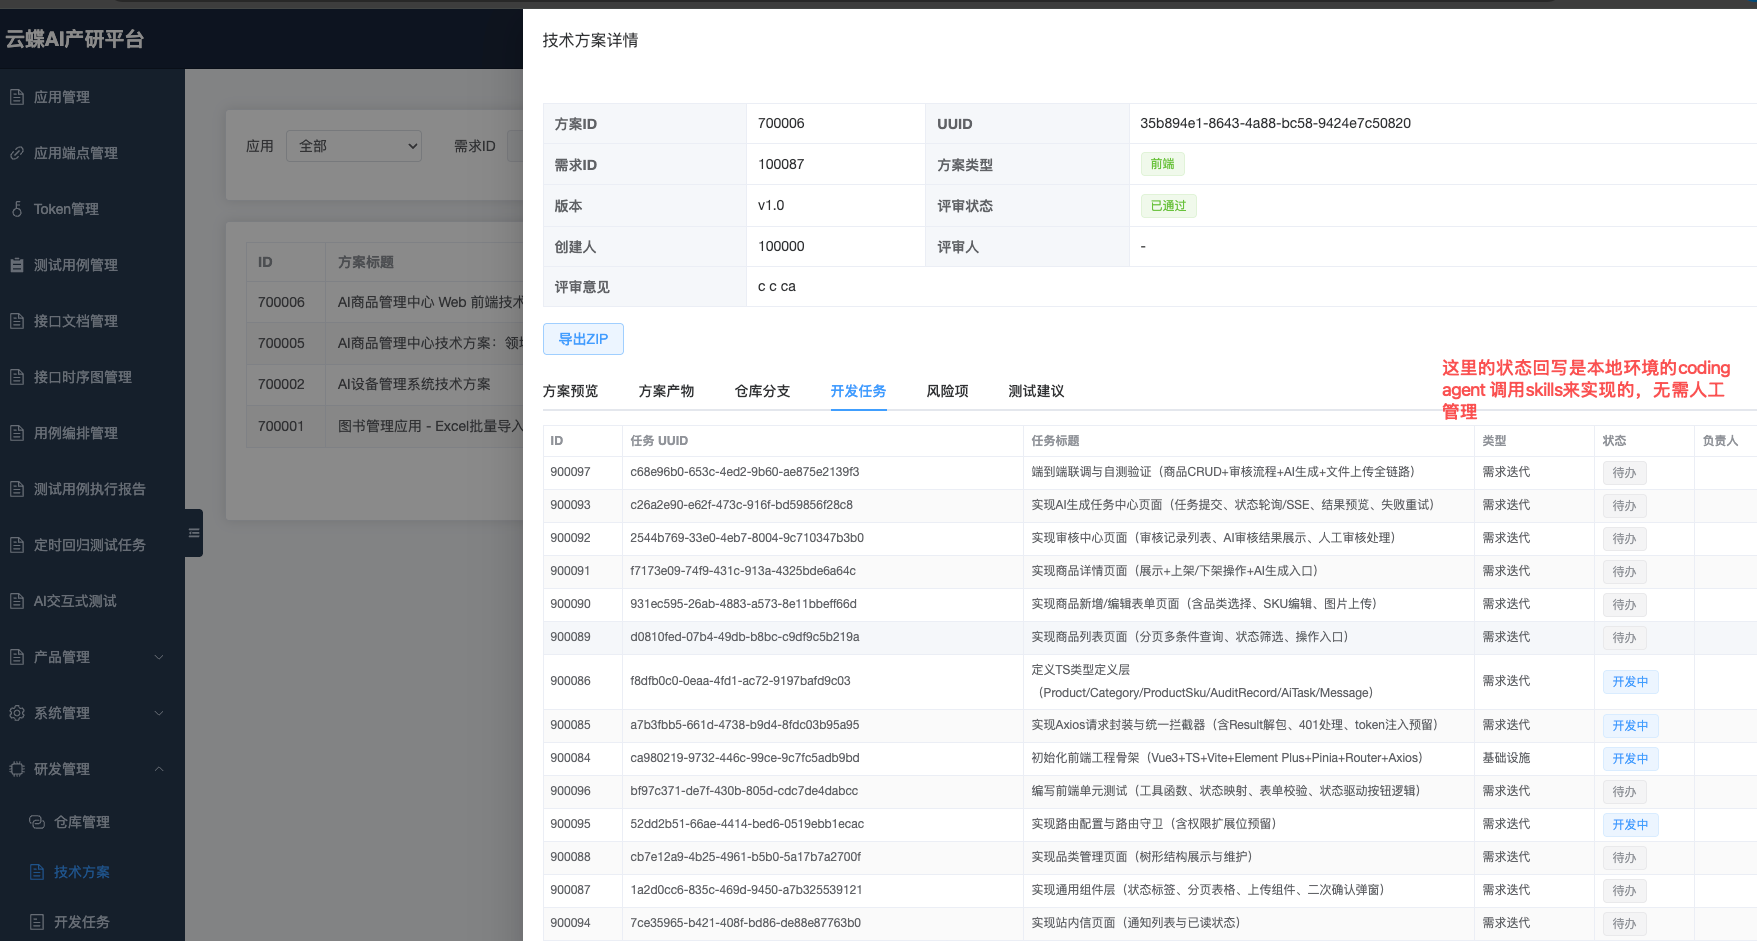
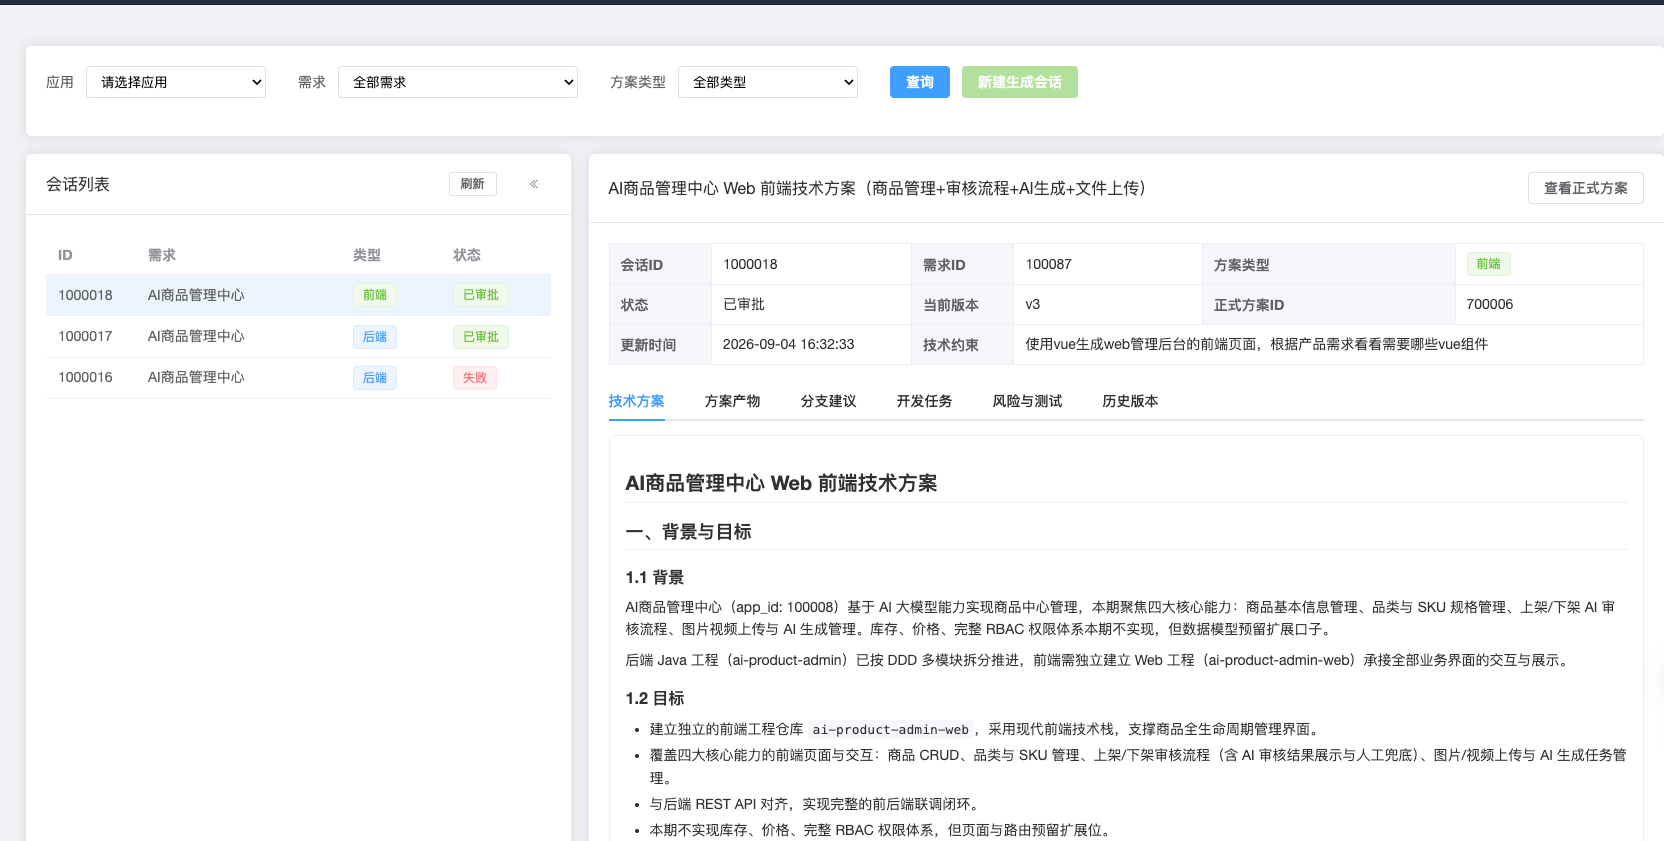
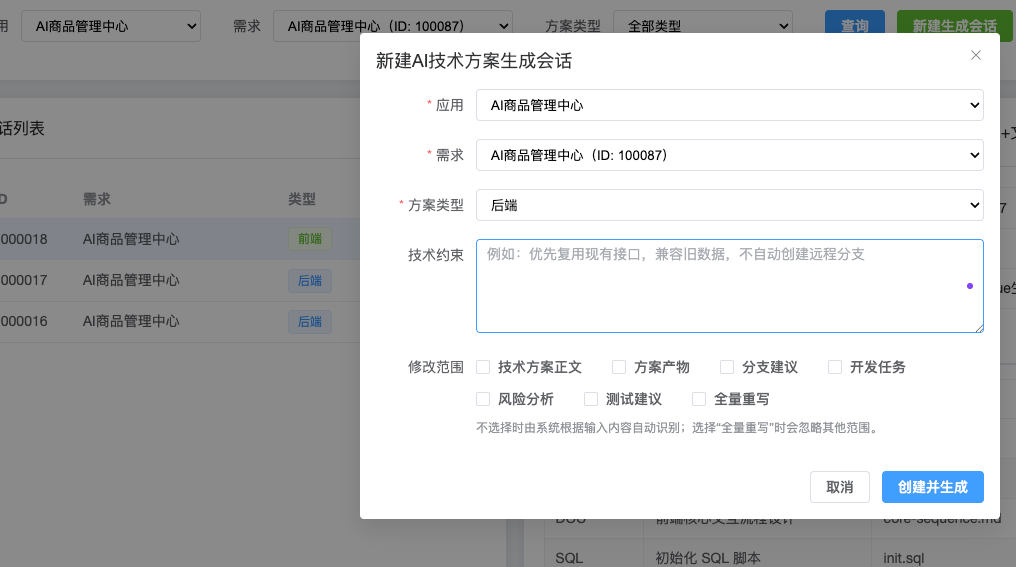
四、后续规划
下面是上一版本的需求规划
实现产品端到研发端的业务数据打通和链路打通(P0)实现研发端的Agent和skills,生成方案文档,研发任务和子任务(P0)- 产品端到测试端的测试用例,用户故事生成,用例脑图生成(P1)
研发端到代码平台(gitee,gitlab,github)和本地开发环境的链路打通(P1)- 研发端到测试端的链路打通(P1)
- 测试端Agent和Skills建设(P1)
后续会优化测试端的板块,重新梳理菜单模块,同时完善测试端的Agent和Skills,构建完整的测试场景和测试功能,增加智能体测试相关的能力,同时支持接入沙箱环境,打通测试到部署的流程。
长期规划就是基于当前已有的项目能力,构建项目管理模块和相关Agent;
五、代码运行
有公众号粉丝问我代码相关的内容,这里跟大家说一下哈,代码是开源的,地址这里再写一下
天画项目/devTestPlatWeb: 云蝶AI产研平台的web端
天画项目/devTestPlat: 云蝶AI产研平台的Java端
天画项目/devTestPlatPy: 云蝶AI产研平台的LLM端(Python)
感兴趣的可以给个Star,同时可以拉下代码本地调试下。